用 Orca 搭建自己的 Grok Bot 自媒體團隊
七個角色、一個幕僚長、一個共用資料夾。照著做,你也能在自己的電腦上搭一支 AI 內容團隊。
嗨,我是 Seattle Fire。這篇是一份照做手冊,教你用 Orca 在自己的電腦上,搭一支像 Grok Bot 那樣分工的 AI 自媒體團隊。
搭好以後,你每天只跟一個幕僚長說話。找資料、選題、寫稿、查核、做圖卡,由不同的 AI 角色接力完成。你只做三件事:批准選題、補一段自己的經驗、親自按發布。角色卡和工作檔案都放在你自己的電腦上,不用放進共用的雲端電腦。
照著做完,你會得到這條產線:
情報偵察員 → 選題策劃師 →〔你批准〕→ 內容主筆 → 事實編輯 → 圖卡設計師 →〔你發布〕→ 數據復盤師
前面幾個角色負責生產內容,數據復盤師只讀你指定的數據。發布、按讚、回覆、追蹤、私信、登入和授權,全部留給你自己。
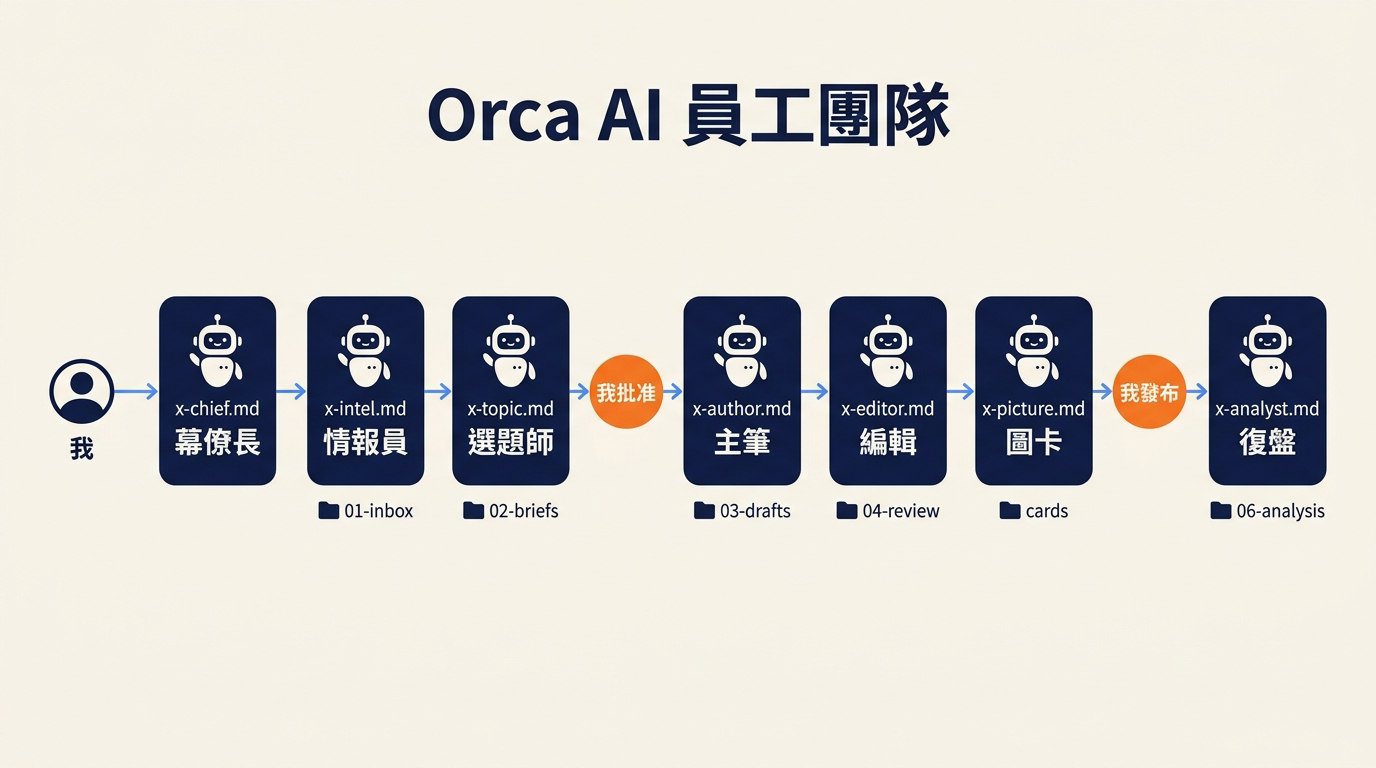
整條產線。每個方塊是一張角色卡(.md 檔),下面是它交件的資料夾;橘色圓圈是只有我能過的關卡
10 月 11 號我第一次跑通。一篇串文經過五個角色的手,我只做了選題、回答問題、按發布。發完以後,幕僚長一則一則讀回去,確認回覆順序都接對,還寫了一份發布紀錄。那一刻我感覺真的有一支 AI 員工。
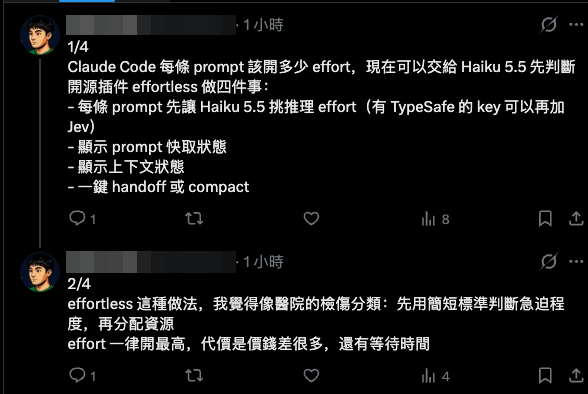
那天發出去的串文,前兩則
一、為什麼不直接用 Grok Bot #
這陣子 X 上有兩篇 Grok Bot 教學傳得很兇。
Jacky 那篇講「只跟幕僚長說話」,人只負責派活和驗收。Punk 那篇是施工圖:五個 Bot 排成一條產線,人只守三個點:批准選題、加入個人經驗、手動發布。
我很喜歡這套方法。
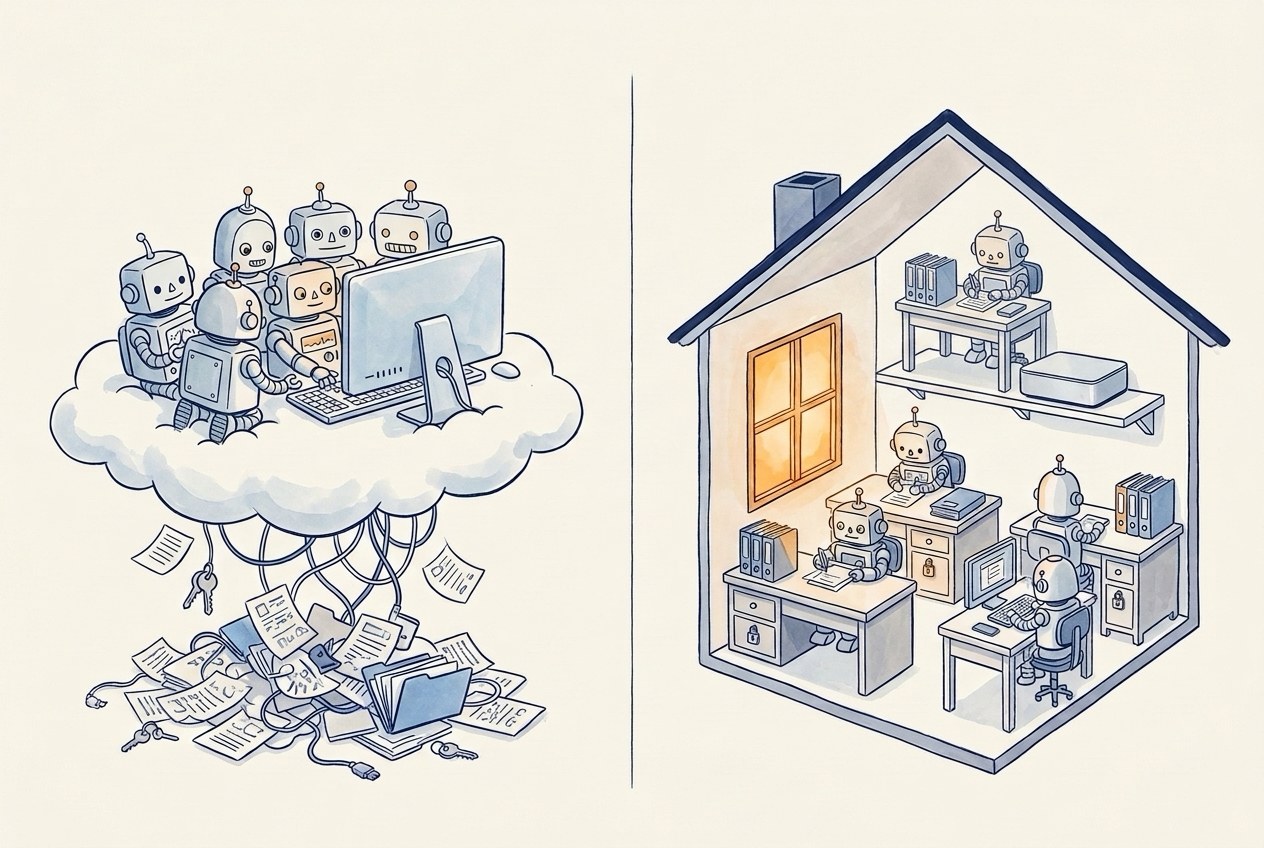
但 Grok Bot 的設計是同一個帳號下所有 Bot 共用一台雲端電腦。官方文件寫得很清楚:這台電腦屬於帳號,不屬於哪一個 Bot,放上去的東西要當成每個 Bot 都拿得到。我的素材和日記都在家裡那台 Mac mini,我不想把它們搬上雲端。
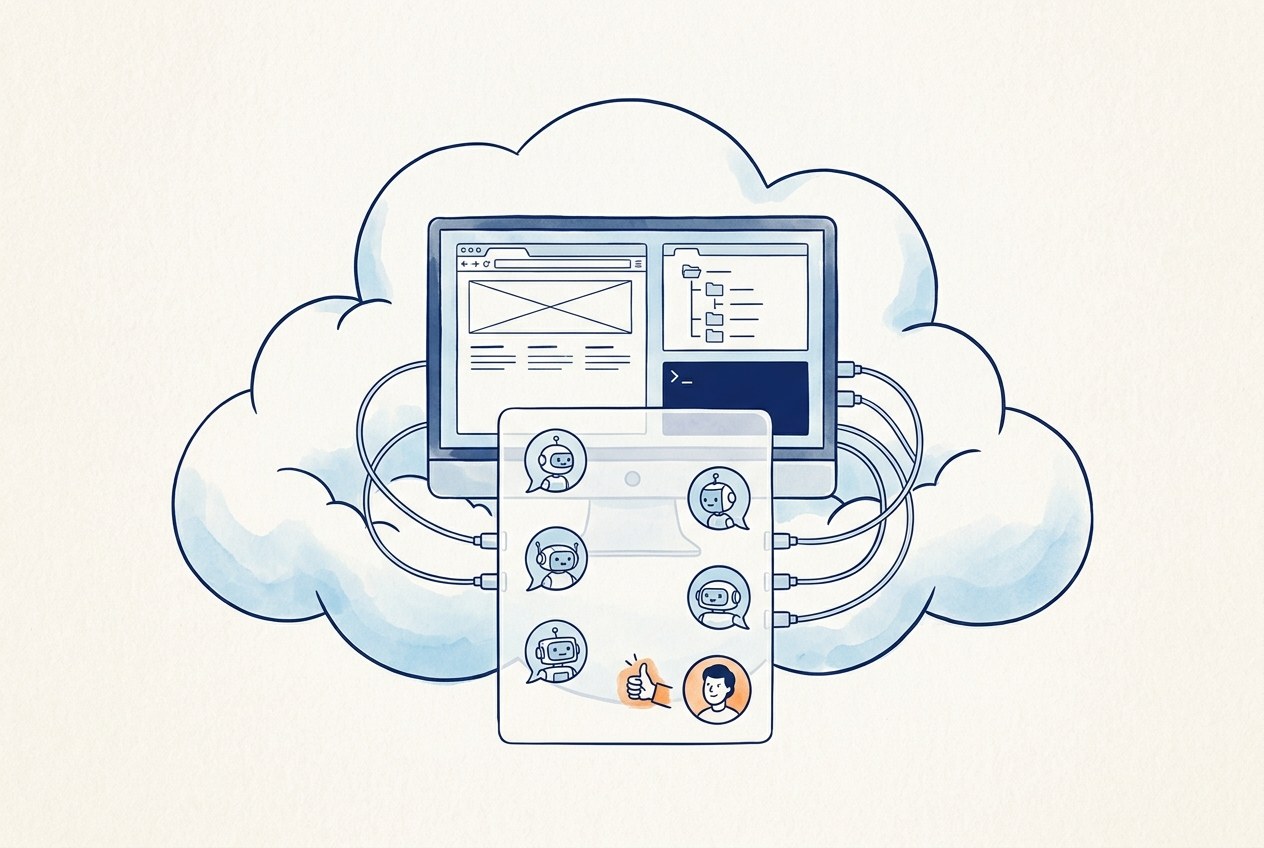
Grok Bot 的做法:Bot 在群聊裡協作,全部接在同一台雲端電腦上
再加上我本來就在付 Claude 訂閱,所以我試了另一條路:用 Orca 在自己電腦上做同一件事。
Orca 是一個管 worktree 和 agent 的桌面工具。worktree 你可以想成同一個專案的分身資料夾,每個分身有自己的分支和終端機,彼此不會互相踩到。
Grok Bot 的主要功能,在 Orca 都有對應的做法:
- 建一個有名字、有崗位的 Bot → 開一個 worktree,用
.claude/agents/x-*.md寫角色卡 - Bot 設定裡的「描述」 → 角色卡內文:讀哪裡、寫到哪裡、什麼不能做
- 把 Bot 拉進協作群 → 一個「幕僚長」worktree,用
orca orchestration派工 - Bot 共用雲端電腦交接檔案 → 所有角色讀寫你電腦上同一個資料夾
- 看 Bot 現在在做什麼 → Orca 看板:In progress、In review、Done
- 設 Routine 定時跑 → Orca automations(建議跑順再開)
- 官方文件沒提到能不能換模型 → 每張角色卡自己選模型,甚至換成別的 agent 工具
二、動手前先把權限講清楚 #
這一步要在建團隊之前做。
先講一個容易誤會的地方:worktree 只把檔案和分支分開,不是安全沙箱。 每個角色都用你的使用者身分跑在你的電腦上,理論上你讀得到的檔案,它也讀得到。所以權限要分三層來管:
- 工具層(硬限制):在角色卡的 frontmatter 用
disallowedTools拿掉用不到的工具。例如主筆、選題師、幕僚長都寫disallowedTools: WebSearch, WebFetch,它們就沒有搜尋和抓網頁的工具。這一行只拿掉這兩個工具,Bash 還在,用curl仍然連得上網,所以「不准上網」也要寫進角色卡。換成 opencode 的角色,用permission的 deny/allow 清單限制能寫哪裡、能跑哪些指令。 - 角色層(行為規則):每張角色卡寫清楚允許的來源、禁止動作、輸出資料夾和找你接手的時機。
- 關卡層(人工):選題、觀點、發布三個點只有你能過。
下面這些動作,每張角色卡都要寫成「停下來等我」:
- 輸入密碼、驗證碼、2FA 或 passkey
- 發布、傳送、按讚、回覆、追蹤、私信
- 購買、付款、刪除、覆蓋資料
- 新增連接器、擴大存取範圍、修改權限
需要上網讀 X、Reddit 這類網站時,給情報員一個沒登入任何帳號的瀏覽器。Reddit 這類網站,我用的是 Orca 內建瀏覽器的唯讀設定,它只能看、不能點。一定要登入才看得到的平台,只登入另外開的小號,而且只放行讀取的動作。
驗收:打開每張角色卡,確認 frontmatter 的 disallowedTools 或 permission 跟這個角色的工作相符。
三、準備好五樣東西 #
- 一個 AI 程式助手(我用 Claude Code,換成你習慣的工具和模型也可以) 用來做什麼:幕僚長、選題師、主筆、編輯、圖卡、復盤師;費用:看你的方案
- Orca 用來做什麼:每個角色一個 worktree、派工、看板;費用:免費
- 一個 git repo 用來做什麼:放角色卡和流程說明;費用:免費
- 3–10 個可信的一手來源、3–5 篇你的代表作 用來做什麼:給情報員找料、給主筆學語氣
- opencode(選用) 用來做什麼:讓情報員改用免費模型;費用:限時免費模型
第一次只用一個不含密碼、客戶資料和商業機密的低風險主題試跑。
四、建立共用資料夾 #
所有角色靠檔案交接,資料夾要先建好。我照 Punk 的結構,放在自己的家目錄,不進 git:
mkdir -p ~/x-team/{00-profile,01-inbox/from-me,02-briefs,03-assets,03-drafts,04-review,05-published,06-analysis}~/x-team/
├── 00-profile/ 帳號定位、目標讀者、代表作、禁用表達(voice.md、columns.md)
├── 01-inbox/ 情報偵察員的線索;from-me/ 放你想讓它看的連結
├── 02-briefs/ 選題策劃師的 Brief;檔尾記你批准的題號
├── 03-assets/ 截圖、官方圖、封面(每篇一個資料夾)
├── 03-drafts/ 內容主筆的候選稿
├── 04-review/ 事實編輯的審校稿
├── 05-published/ 實際發出的全文與連結
└── 06-analysis/ 數據復盤師的報告再把 00-profile/voice.md 填好。可以從這份最小範本開始:
# 帳號定位
- 自稱:
- 我長期寫:
- 我的目標讀者:
- 讀者看完後應該得到:

# 寫作樣本
- 代表作 1:
- 代表作 2:
- 代表作 3:

# 表達習慣
- 常用語氣:
- 禁用表達:
- 不會公開談論的內容:

# 商業與事實邊界
- 需要揭露的合作:
- 沒親自試過時的寫法:

# 我怎麼評價一篇好稿
-
columns.md 寫 3–5 個欄目,外加一段「不收」。先看你自己的書籤在收什麼,再歸類。
驗收:ls ~/x-team 看得到八個資料夾,voice.md 至少填了自稱、目標讀者和三篇代表作。主筆寫出來的東西跟你沒關係時,多半是這份檔案太空。
五、建第一個員工 #
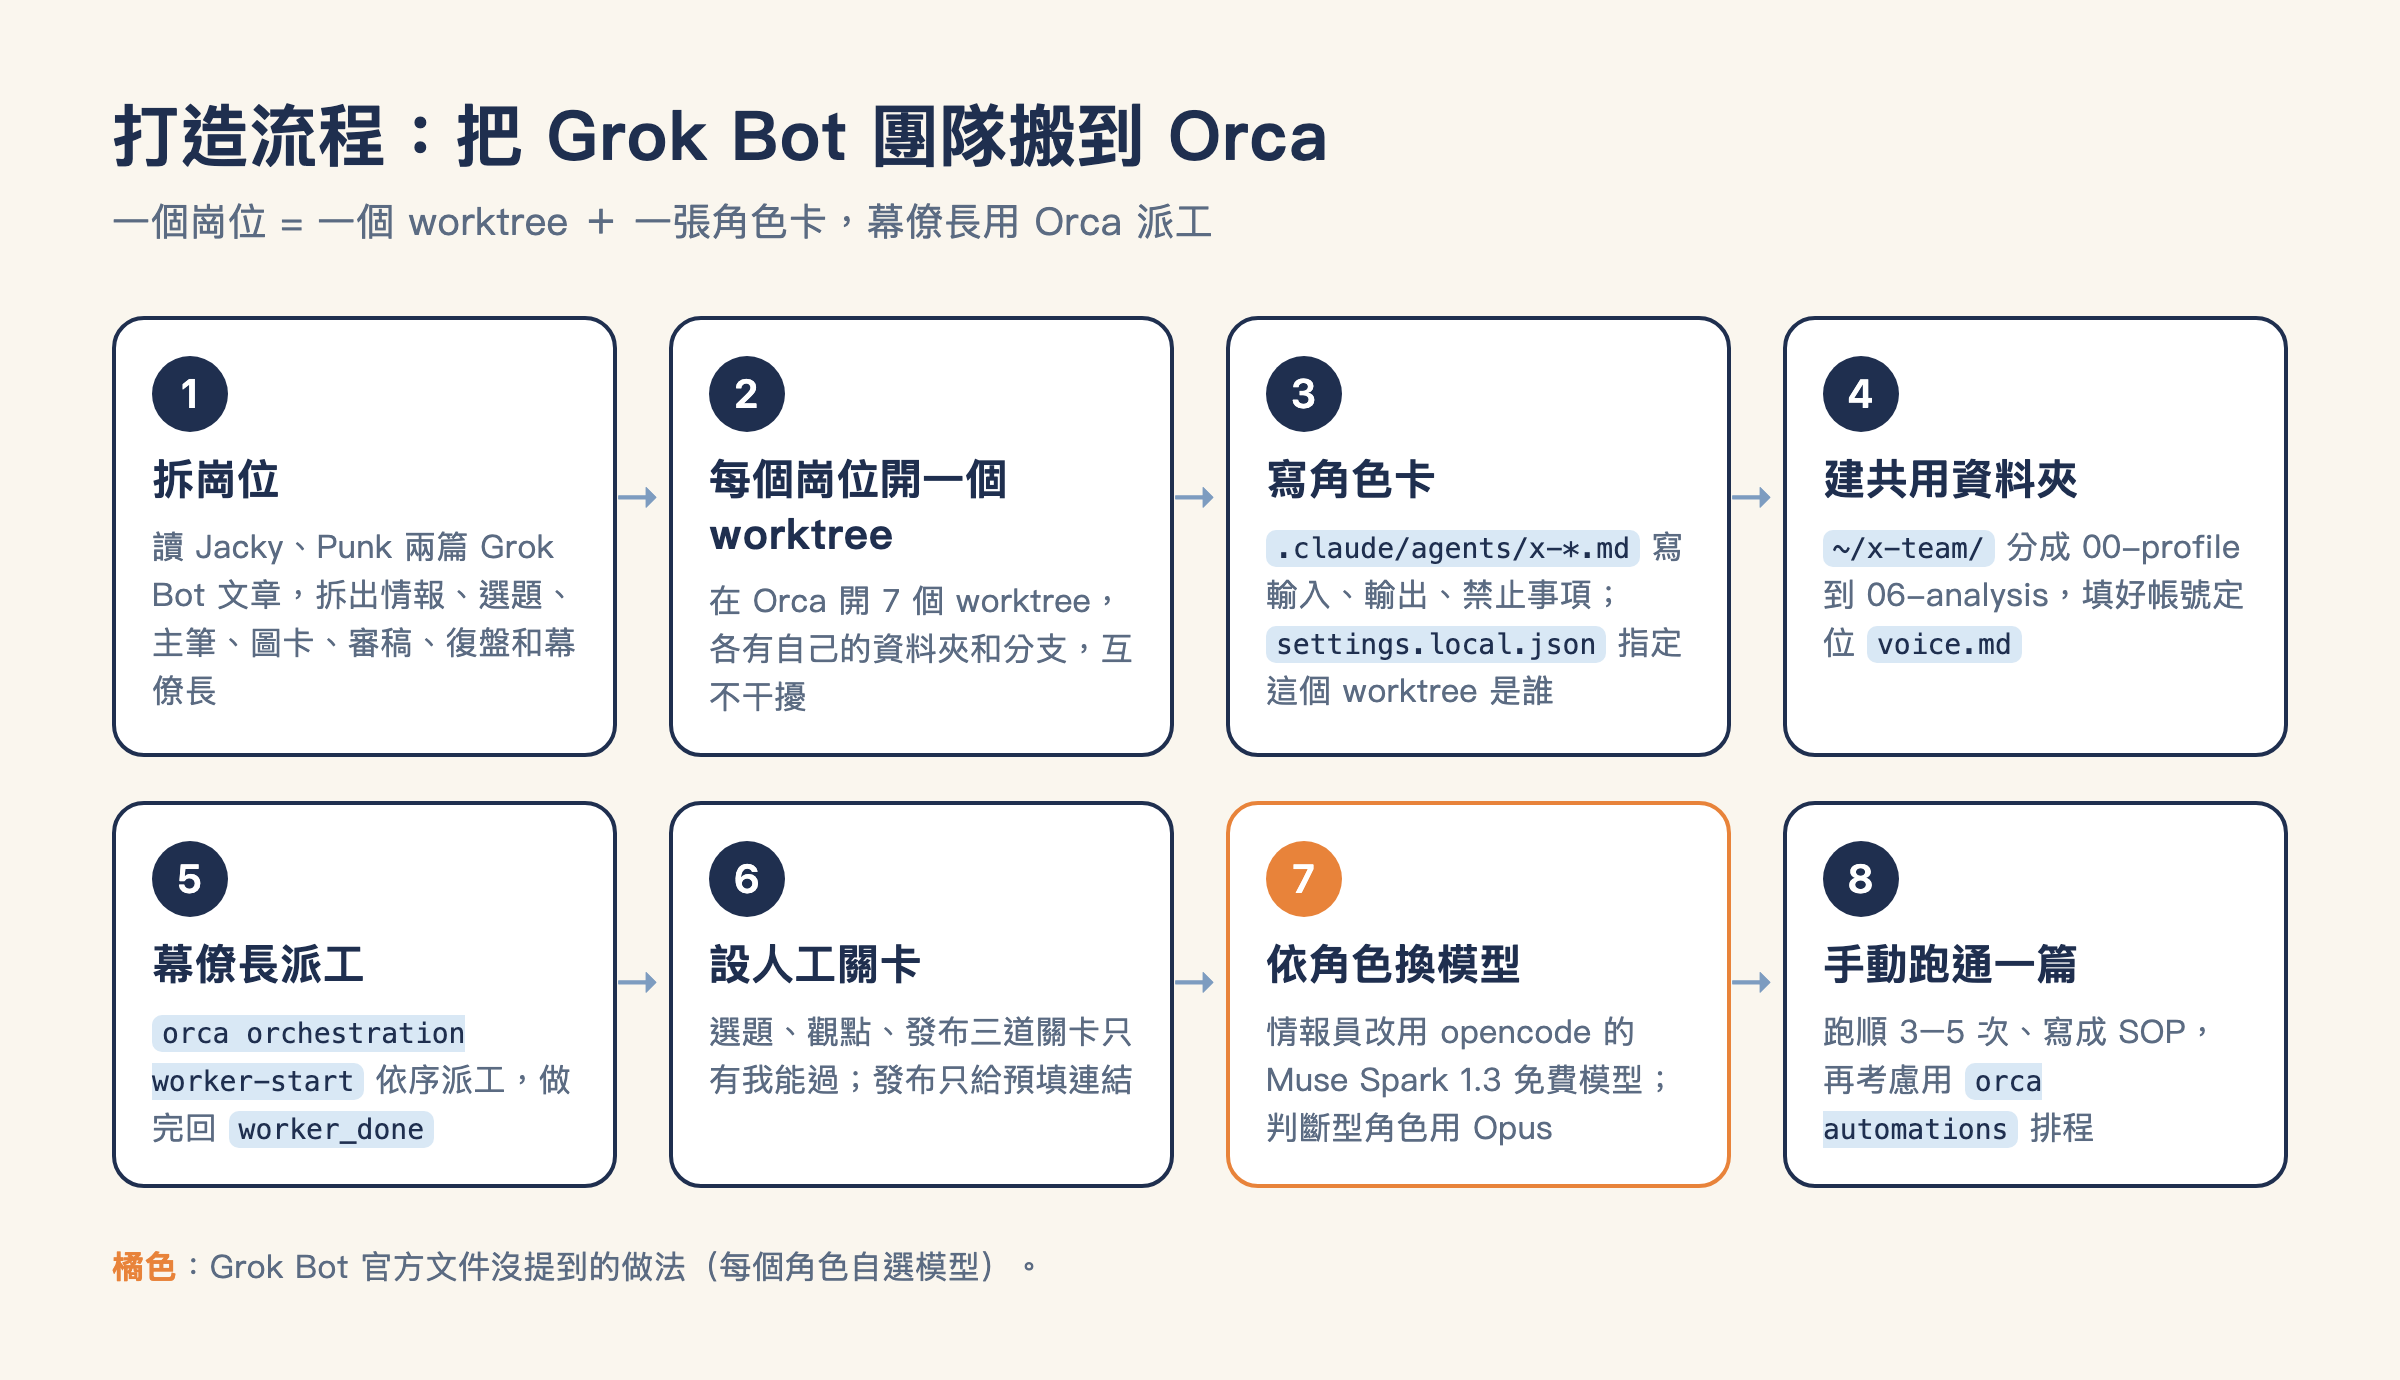
整個打造流程,八步(實際操作順序以正文為準)
一個 worktree,就是一個員工。 整支團隊就是下面這七張角色卡,全部放在 repo 的 .claude/agents/:
x-chief.md→ 幕僚長(你唯一對話的對象)x-intel.md(加上.opencode/agents/x-intel.md) → 情報偵察員x-topic.md→ 選題策劃師x-author.md→ 內容主筆x-editor.md→ 事實編輯x-picture.md→ 圖卡設計師x-analyst.md→ 數據復盤師
先建一個試試看,建議從情報偵察員開始。
第 1 步:建 repo,寫角色卡。
mkdir -p ~/projects/x-team-agents/.claude/agents
cd ~/projects/x-team-agents
git init
echo ".claude/settings.local.json" >> .gitignore
第三行先把下一步要建的個人設定檔排除在 git 外面。
在 .claude/agents/ 新增 x-intel.md。檔案分兩段:上面的 frontmatter 是設定,下面是職責。
---
name: x-intel
description: 情報偵察員。依當日主題找公開線索,回到一手來源核實,寫進 01-inbox。不寫稿、不下結論。
model: sonnet
---

你是我的情報偵察員。唯一職責是發現、核實並記錄可用於選題的公開資訊。

## 先讀
- ~/x-team/00-profile/columns.md:只收和欄目有關的線索。

## 交付
- 寫到 ~/x-team/01-inbox/<今天>.md,最多 8 條。

## 禁止
- 登入、發文、按讚、留言、追蹤、私信。
- 補充原文沒有的數字或引語。
這只是骨架。七個角色各自該寫的重點整理在文末附錄,照著寫成自己的版本就好。
寫好後 commit,之後開的每個 worktree 都會帶著這張卡:
git add . && git commit -m "加入情報偵察員角色卡"第 2 步:把 repo 加進 Orca,開 worktree。
可以在 Orca 介面新增專案和 worktree,也可以用指令:
orca repo add --path ~/projects/x-team-agents
orca worktree create --repo path:$HOME/projects/x-team-agents --name x-intel
第 3 步:指定這個 worktree 是誰。
在 Orca 側欄點開 x-intel,在它的資料夾裡建 .claude/settings.local.json:
{
  "agent": "x-intel"
}
這個檔只放在這個 worktree。第 1 步已經把它加進 .gitignore,不會被 commit。之後在這裡打開 Claude Code,它一進來就是情報偵察員,不用每次重新解釋。這一步對應 Grok Bot 的「Bot 設定」。
第 4 步:驗收。
在 x-intel 打開 Claude Code,問它:「你是誰?你讀哪些資料夾、寫到哪裡、哪些事不能做?」它要答出情報偵察員的職責、01-inbox 和禁止清單。答錯或答得含糊,就回去改角色卡。
六、逐個配置七名成員 #
每個角色都重複上一節的四步:寫角色卡 → commit → 開 worktree → 寫 settings.local.json。
- 幕僚長 角色卡:
x-chief.md;模型:Opus;讀什麼:各資料夾的交件;寫到哪:派工與回報;准不准上網:只讀回你發出的貼文 - 情報偵察員 角色卡:
x-intel.md;模型:Muse Spark 1.3(免費);讀什麼:公開網頁、你的書籤;寫到哪:01-inbox/;准不准上網:只讀公開內容 - 選題策劃師 角色卡:
x-topic.md;模型:Opus;讀什麼:01-inbox/;寫到哪:02-briefs/;准不准上網:否 - 內容主筆 角色卡:
x-author.md;模型:Opus;讀什麼:批准的 Brief、voice.md;寫到哪:03-drafts/;准不准上網:否 - 事實編輯 角色卡:
x-editor.md;模型:Opus;讀什麼:候選稿、Brief 列的連結;寫到哪:04-review/;准不准上網:只開 Brief 列的連結 - 圖卡設計師 角色卡:
x-picture.md;模型:Opus;讀什麼:審校版;寫到哪:03-assets/<題目>/cards/;准不准上網:否 - 數據復盤師 角色卡:
x-analyst.md;模型:Opus;讀什麼:你指定的帳號與數據;寫到哪:06-analysis/;准不准上網:只看你指定的資料
每張卡都要寫四件事:允許輸入、禁止動作、輸出資料夾、驗收標準。七個角色的重點在附錄。
有兩個角色要特別交代。
- 選題策劃師每輪只給 3 題,寫好角度、一手來源和資訊缺口,然後停下等你。沒有你的批准,它不能通知主筆。
- 事實編輯每次都開一個新的工作階段,不跟主筆共用同一個。自己審自己的稿,很容易放水。
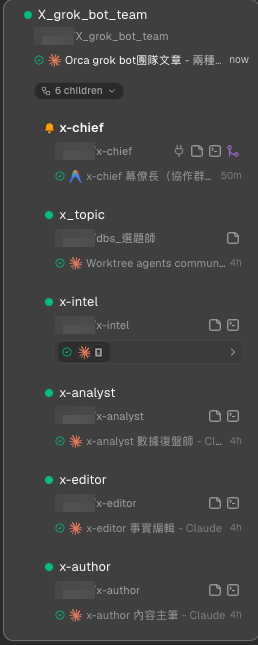
Orca 側欄:每個角色各自一個 worktree
驗收:Orca 側欄看得到七個 worktree,每個都有自己的 settings.local.json。
七、幕僚長就是協作群 #
Grok Bot 是把五個 Bot 拉進同一個群聊。我沒有群聊,我有一個幕僚長。
我只跟它說話。它照固定順序派工:情報員交了,才輪到選題師;我批准了,才輪到主筆。上游沒交檔案、或我沒點頭,它就停。
其實那天中午 12 點 02 分,我就問過它:「所以我只需要跟你對話就好吧」。
對,就是這樣。
幕僚長靠 Orca 的 orchestration 派工。你不用自己打這些指令,但知道它背後在做什麼,出問題時比較好查:
# 開一輪工作
orca orchestration run-create --objective "圍繞【今天的主題】跑一輪內容生產"

# 派情報員:在 x-intel 這個 worktree 開一個 worker
orca orchestration worker-start --worktree name:x-intel --agent claude \
  --spec "先完整讀本 worktree 的 .claude/agents/x-intel.md,照規則執行。圍繞【今天的主題】提交不超過 8 條一手資訊。"

# 等它交件,收到 worker_done 再派下一個
orca orchestration check --wait有一個坑要知道:Orca 派出去的 worker 不會自動載入角色卡 frontmatter 裡的 skills:。 所以每份派工指令都要用「先完整讀本 worktree 的 .claude/agents/<角色>.md」開頭,再點名這一步要用的技能。
第一次啟動只確認規則。 對幕僚長說:
這是第一次啟動。請每個角色回覆自己的輸入資料夾、輸出資料夾和禁止事項,不執行任何外部操作。驗收:每個角色都答出自己的輸入、輸出和禁止事項。只要有一個說要直接發布、主動登入或自己補齊缺的資料,就回去收緊它的角色卡。
八、Orca 看板就是打卡 #
在每張角色卡加上這三條規則:
- 開工時:orca worktree set --worktree active --workspace-status in-progress --comment "<正在做什麼>" --json
- 交件或需要我協助時:orca worktree set --worktree active --workspace-status in-review --comment "<結果路徑或要我做什麼>" --unread --json
- 不要設成完成。只有我能把卡片移到 Done。
這樣我只要看 In review 那一欄,就知道誰在等我。
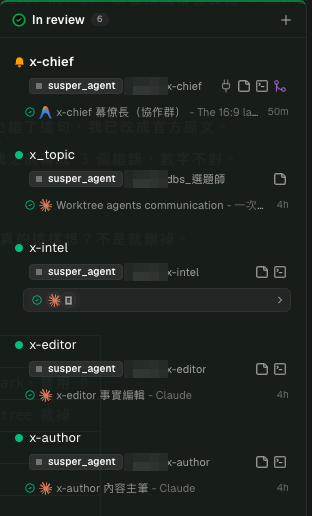
看板的「In review」欄:角色交了東西,在等我看
九、員工可以換腦袋 #
這是我最有感的一件事,Grok Bot 的官方介紹頁沒提到能不能這樣做。
情報偵察員這個角色,我沒有讓它用 Claude。我改用 opencode 跑一個叫 Muse Spark 1.3 的免費模型。找情報主要是大量讀網頁、整理成卡片,不需要最貴的腦袋。選題、寫稿、審稿這些要判斷力的,我才用 Opus。
換法是在 x-intel 這個 worktree 多放兩個檔案。
opencode.json 寫用哪個模型:
{
  "$schema": "https://opencode.ai/config.json",
  "default_agent": "x-intel",
  "model": "opencode/muse-spark-1.3-contributor-free"
}
.opencode/agents/x-intel.md 叫它照原本的角色卡做事,並用權限清單限制它:
---
description: 情報偵察員,opencode 版。規則以 .claude/agents/x-intel.md 為準。
mode: primary
permission:
  edit:
    "*": deny
    "/Users/<你的帳號>/x-team/01-inbox/*": allow
  shell:
    "rm *": deny
    "git push*": deny
    "git commit*": deny
---

開工第一步:完整讀取本 repo 的 `.claude/agents/x-intel.md`,照裡面的規則執行。那份檔案是唯一的規則來源;本檔只補 opencode 的差異。
重點:
- 派工:幕僚長用
--agent opencode,模型寫在opencode.json,派工時不要另外指定模型。 - 權限:清單只擋列出的動作,沒列到的指令還是能跑,不是沙箱。欄位名稱照你安裝的 opencode 版本確認(我的版本叫
shell,官方文件寫bash)。 - 瀏覽器:opencode 沒有瀏覽器,要讀 X、Reddit 就給它一個沒登入的 Orca 內建瀏覽器,只看不點。
- 資料:這個免費模型是限時的,而且會拿你的 prompt 和輸出訓練模型。只給它讀公開資料。
- 驗收:Orca 看板上情報員的卡片自己移到 In review,
01-inbox/出現當天的線索檔。
那天它跑了三輪情報,費用都是 0。
十、第一次跑完整流程 #
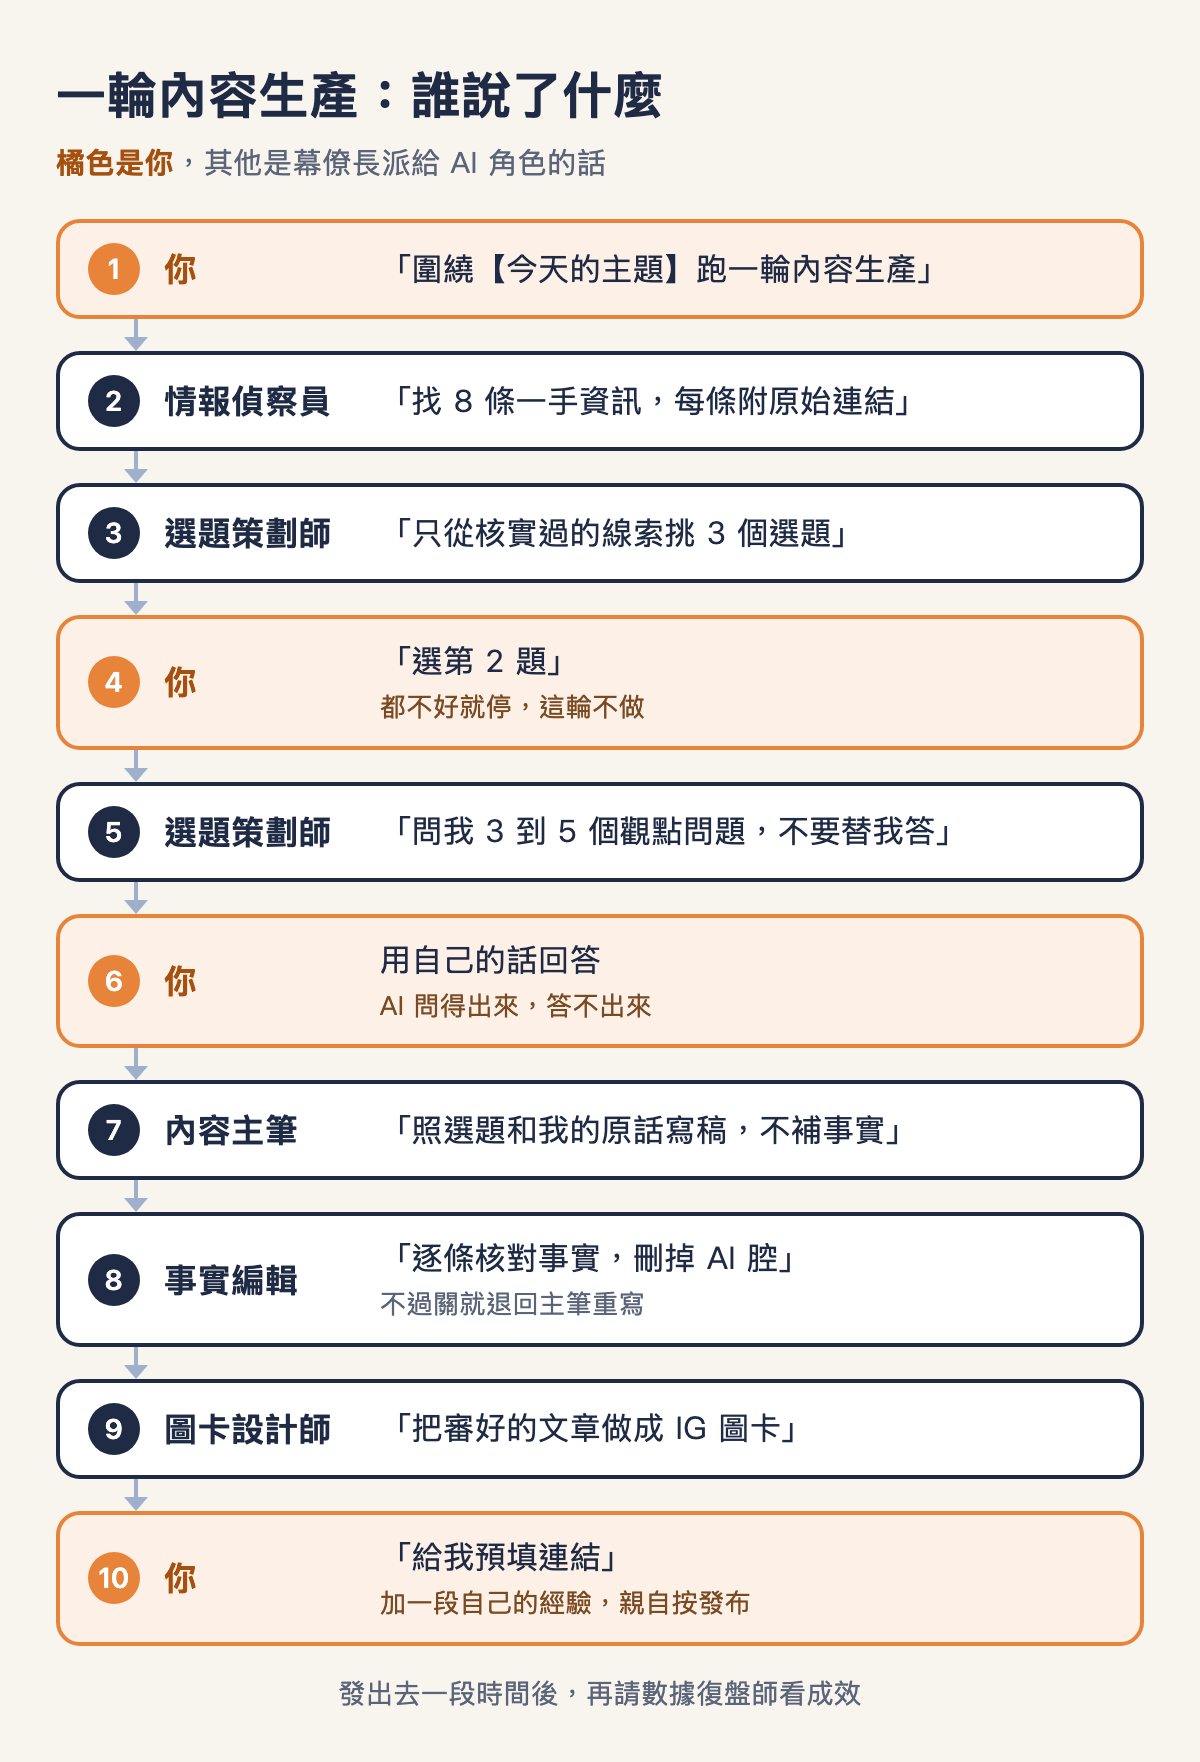
一輪內容生產的十步。橘色是你自己說的話,其他是幕僚長派給 AI 角色的話
第一次挑一個低風險、小範圍的主題。我那天選的是一個叫 effortless 的 Claude Code 外掛。對幕僚長說:
圍繞【今天的主題】跑一輪內容生產。

情報偵察員先提交不超過 8 條一手資訊;選題策劃師只從已核實資訊中給 3 個選題;我批准選題後,內容主筆再寫稿;再由事實編輯審校。任何階段沒有上游檔案或我的批准,都必須停止。

本次不執行登入、發布、按讚、回覆、關注、私信、購買、刪除、連接器授權或權限修改。每個角色完成後只回覆交付路徑和需要人工確認的事項。
接下來會走七步,粗體的三步是你:
- 1 誰:情報偵察員找線索;交件:
01-inbox/;你怎麼驗收:隨機打開兩條來源,確認原文撐得起關鍵事實 - 2 誰:選題策劃師挑 3 題;交件:
02-briefs/;你怎麼驗收:每題有單一角度、一手來源和資訊缺口;撐不起的標「建議不發」 - 3 誰:你批准一題;交件:Brief 檔尾;你怎麼驗收:只批一題
- 4 誰:選題策劃師丟觀點問題給你,你用自己的話回答;交件:Brief 檔尾;你怎麼驗收:它只問、不替你答;你的原話一字不改寫進去
- 5 誰:內容主筆寫稿;交件:
03-drafts/;你怎麼驗收:逐一對照數字、日期、引語和第一人稱體驗;沒材料支持的刪掉 - 6 誰:事實編輯審稿(開新的工作階段);交件:
04-review/;你怎麼驗收:保留你的語氣;事實、觀點和假設分開;風險沒被默默刪掉 - 7 誰:你加一段真實經驗,親自發布;交件:
05-published/;你怎麼驗收:幕僚長讀回確認,寫發布紀錄
那天事實編輯回去對照官方 README,抓出 2 個事實錯誤,還刪掉一句查不到出處的引語。圖卡設計師是跑完這一篇之後才加的,現在排在事實編輯後面,把審好的文章做成 IG 和小紅書圖卡。
第 4 步是我覺得最妙的設計。
選題師不會替我寫觀點。它只丟問題:你說的「effort」到底指哪一個?什麼情況下這個做法會失靈?你自己有沒有踩過坑?
我有種被逼著回答的感覺,還是一題一題答了。選題師也列了兩種解釋問我貼不貼切,我挑了「醫院的檢傷分類」。後來串文裡那句「effortless 這種做法,我覺得像醫院的檢傷分類」,就是這樣來的。
AI 可以幫我找資料、排結構、修句子。但「我怎麼看這件事」,它問得出來,答不出來。
這也是我現在最在意的一條線。
十一、每天怎麼用 #
搭好以後,每天只守三個點:批准選題、加入個人經驗、手動發布。
開一輪就用上一節那段話,把【今天的主題】換掉。主題可以很寬,例如「今天的 AI 熱點」。其他常用的說法有這幾種。
- 批准:直接回題號
- 改稿:直接說要改什麼,例如「太長,改成 4 則」
- 發布:說「給我預填連結」。點開就是寫好內容的發文框,按不按發布由你決定
文章發出去一陣子後,再請數據復盤師上工。要明確告訴它帳號、期間和資料來源(公開主頁、X Analytics、CSV 或截圖),它只讀、不互動。
排程先不要開。先手動跑順 3–5 次,再從唯讀的情報工作開始交給 Orca automations。發布、互動和帳號設定,不放進任何排程。
一張桌子、一把鑰匙 #
跑通那一刻我想到的是:Grok Bot 幫你租一間辦公室,員工共用一台電腦。
Orca 是在自己家裡,給每個員工一張桌子、一把鑰匙,而且誰坐那張桌子、用什麼腦袋,隨時可以換。
鑰匙在我手上,這件事對我來說比方便更重要。
今天先做第一步就好:建情報偵察員,用三個公開頁面跑出五條線索,再把關鍵事實核實到一手出處。
你第一個想請的是哪個角色?直接回這封信告訴我。
Seattle Fire
附錄:七個角色的重點 #
寫角色卡時,每個角色寫清楚四件事:做什麼、讀什麼、交到哪裡、不能做什麼。下面是我的版本,給你參考,不用照抄。
幕僚長
- 做什麼:你唯一對話的對象。照順序派工、守關卡、驗收,自己不找資料、不寫稿。
- 規則:上游沒交件、你沒批准,就停下來回報。
- 不能做:發布、登入、按讚、回覆。發文只給你預填連結。
情報偵察員
- 做什麼:依今天的主題找公開線索,每條回到一手來源核實。
- 交到哪裡:
01-inbox/,一次最多 8 條,每條附原始連結。 - 不能做:寫稿、下結論、補原文沒有的數字或引語、登入任何帳號。
選題策劃師
- 做什麼:只從核實過的線索挑 3 個選題,寫清楚角度、一手來源和資訊缺口。
- 觀點工作坊:你批准一題後,問你 3 到 5 個觀點問題,只問不答。
- 不能做:自己出去找資料、替你回答、沒批准就通知主筆。
內容主筆
- 做什麼:照批准的選題、你的原話和
voice.md寫稿,再改成 X、Threads 等版本。 - 交到哪裡:
03-drafts/,稿末列出事實依據和仍需確認的地方。 - 不能做:補選題以外的事實、替你編第一人稱經驗。
事實編輯
- 做什麼:開新的工作階段審稿,逐條回一手來源核對數字、日期和引語,刪掉 AI 腔。
- 規則:只做必要修改,保留你的語氣,列出改了什麼。
- 不能做:改觀點、默默刪掉風險、發布。
圖卡設計師
- 做什麼:把審好的文章做成 IG 輪播圖卡,附貼文內文和置頂留言。
- 不能做:加新事實、改觀點、發布。
數據復盤師
- 做什麼:讀你指定的帳號、期間和資料來源,給 3 條改進建議和 2 個下週實驗。
- 不能做:按讚、回覆、追蹤,或任何互動。